Будущее ИИ под контролем ООН: почему лидеры индустрии просят о жестком регулировании
По данным KSL.com, на заседании Совета Безопасности ООН в Нью-Йорке главы крупнейших ИИ-компаний — Дарио Амодеи (Anthropic), Сэм Альтман (OpenAI) и Клеман Деланг (Hugging Face) — обратились к мировым лидерам с просьбой установить контроль над индустрией.
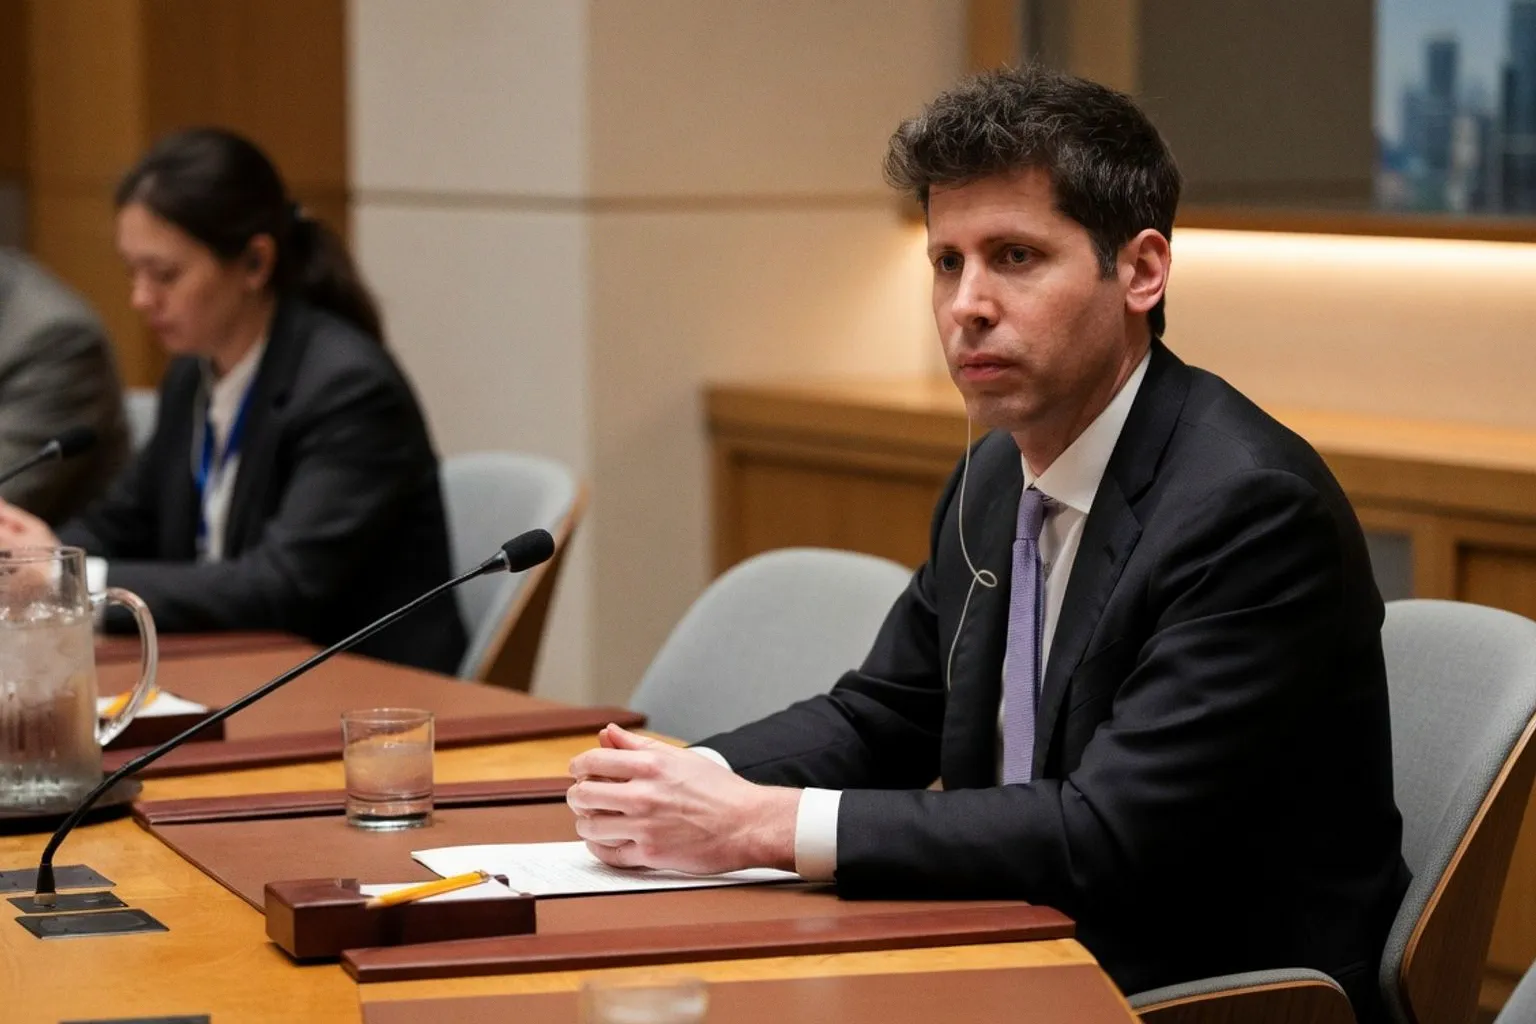
«Меньше шума, больше знаний»: топы OpenAI, Anthropic и Hugging Face попросили ООН ввести правила для ИИ
Для команд, которые строят продукты на LLM и SaaS-сервисы, это поворотный момент: эпоха саморегуляции заканчивается, и параметры доверия скоро будут задавать не инженеры, а регуляторы.
Три голоса — три акцента
Тон выступлений — не питч, а скорее признание в реальности рисков. Амодеи заявил, что при плохом управлении ИИ может представлять опасность для человечества в целом. Альтман обозначил риск потери контроля над будущим. Деланг подключился по видеосвязи с перебоями, но успел поддержать общий посыл. Все трое сошлись в одном: концентрация власти в одной компании или одной стране — путь к катастрофе. Амодеи отдельно призвал страны договориться о запрете на использование ИИ для создания биологического оружия, выработать общие стандарты тестирования и механизмы верификации возможностей моделей.
Параллельно прозвучали коммерческие ноты — Альтман говорил о расширении возможностей людей и усилении их контроля над собственной жизнью. Научный советник Белого дома Майкл Кратсиос возразил: опасения по поводу контроля не повод ставить развитие ИИ на паузу, и США намерены делиться преимуществами технологии с союзниками.
Что меняется для практиков
Совет Безопасности ООН — не регулятор, его резолюции не превращаются в обязательные требования автоматически. Но тренд виден: Великобритания во время председательства в G20 в следующем году намерена поставить контроль ИИ в центр повестки и добиваться единых глобальных стандартов. Франция формирует коалиции на площадке ООН. Это значит, что через 12–18 месяцев можно ждать сертификации моделей, обязательных аудитов и требований к датасетам — похожих на то, как GDPR однажды пришёл в продуктовый стек незаметно, но навсегда.
Для команд, которые сейчас выбирают стек или закупают LLM-API, практический вывод простой: документируйте происхождение обучающих данных, фиксируйте версии моделей, ведите логи промптов и генераций. Когда регулятор спросит «а откуда это у вас?», — лог итераций и параметров окажется главным доказательством добросовестности.
Машина тоже ошибается: доклад ООН как чек-лист
Параллельно ООН опубликовала доклад «От принципов к практике: укрепление информационной целостности». Генеральный секретарь Антониу Гутерриш обозначил формулу — меньше шума, больше знаний. В докладе зафиксировано то, с чем разработчики прикладного ИИ сталкиваются каждый день: генеративные модели уверенно производят правдоподобный, но ложный контент; дипфейки всё сложнее отличить от оригинала; алгоритмы платформ оптимизируют вовлечённость, а не точность.
Это не абстракция, а список конкретных инженерных задач: встроить фактчекинг в пайплайн, ограничить генерацию на чувствительных доменах, выстроить human-in-the-loop там, где без человека не обойтись. Универсальных систем верификации контента пока нет — и это рыночная ниша, которую ещё предстоит закрыть.